data-chat
Pregúntale a tu Excel de ventas en español o inglés: la cifra, el gráfico y cómo se calculó. La IA nunca escribe SQL; el servidor sí, en modo lectura.
Preguntas en lenguaje natural sobre datos de ventas, en .NET 10 con Claude Haiku 5.5: el modelo devuelve una consulta semántica validada contra un esquema generado por archivo, el servidor la compila a SQL parametrizado de solo lectura, el gráfico sale de la forma del resultado y cada cifra del resumen se verifica.
- Rol:
- Diseño y desarrollo
- Año:
- 2026
- preguntas de evaluación respondidas con la cifra correcta
- 75/75
- intentos de manipulación sin efecto sobre los datos
- 20/20
- cifras inventadas mostradas en los resúmenes
- 0
- de costo del modelo por pregunta, resumen incluido
- USD 0,00058
Demo
Capturas
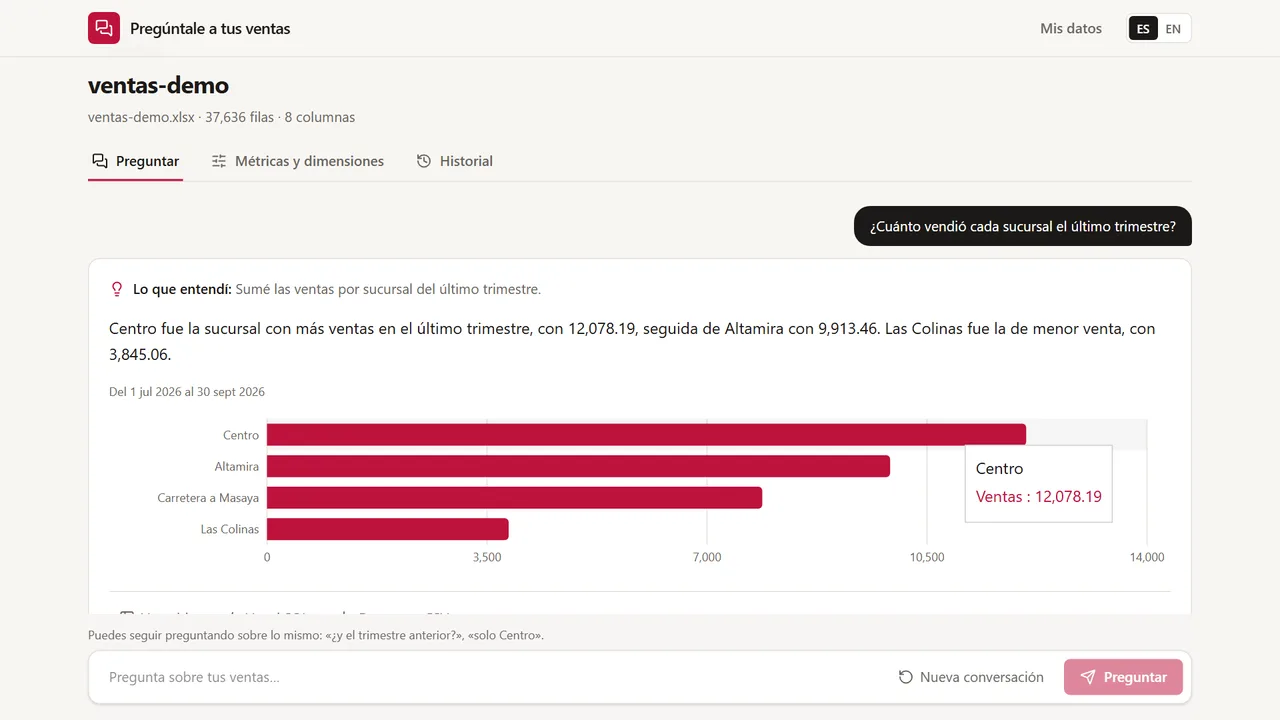
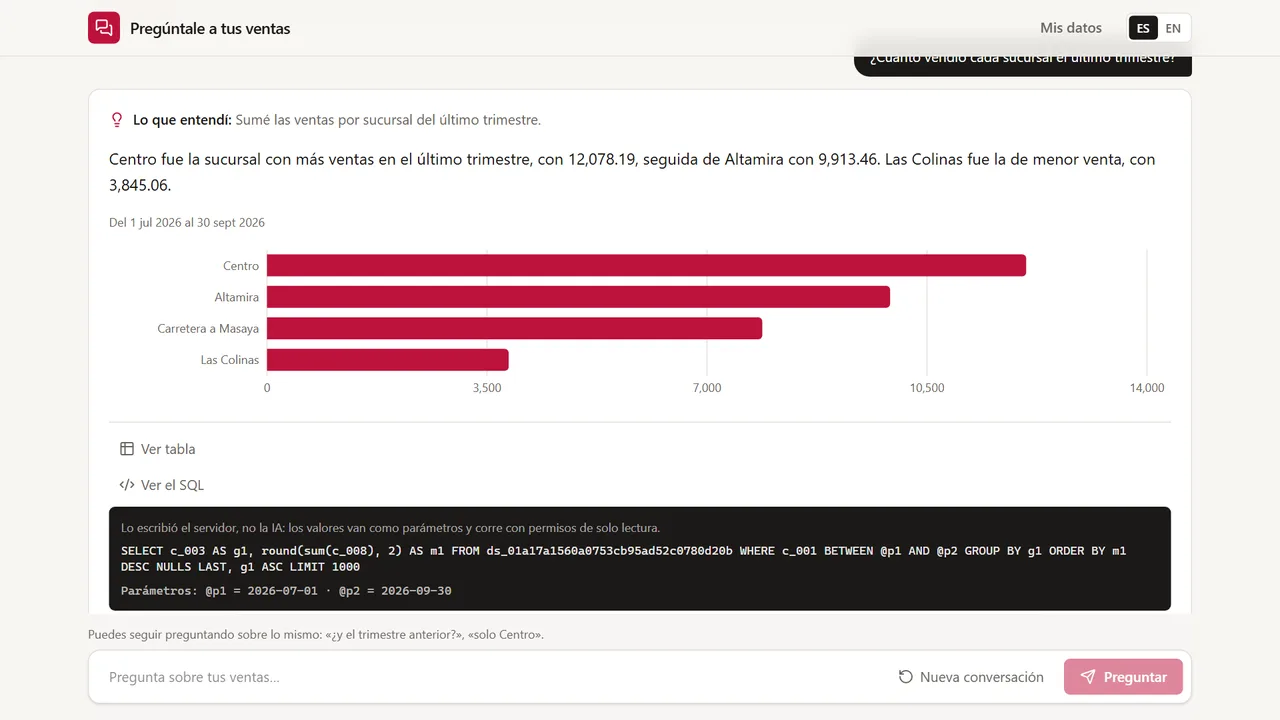
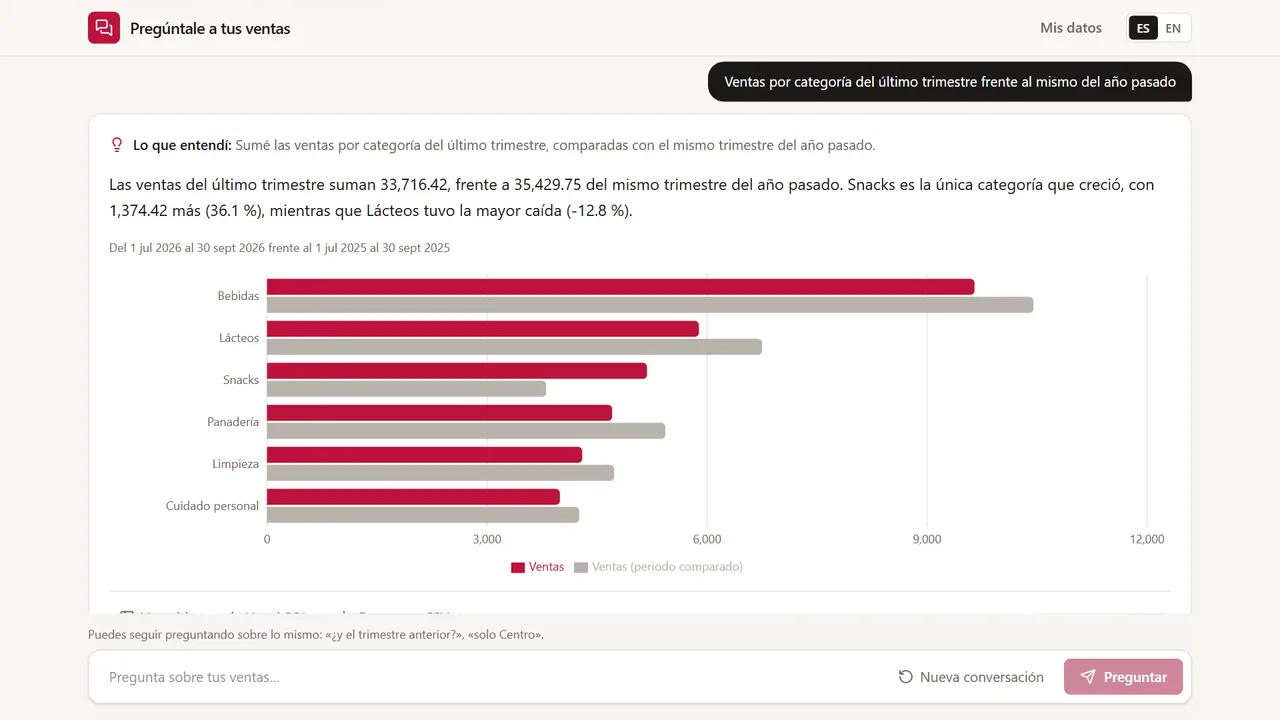
El problema
Las ventas de una PyME viven en Excel, y sacarles una respuesta exige tablas dinámicas o esperar a alguien que sepa. Un "text-to-SQL" ingenuo deja que el modelo escriba SQL contra la base: un riesgo de seguridad y de exactitud, porque un JOIN mal hecho devuelve un número falso con total seguridad. El objetivo era responder en lenguaje natural sin que la IA pudiera tocar ni inventar los datos.
Restricciones
- La IA nunca escribe SQL: traduce la pregunta y el servidor arma la consulta
- Solo lectura: ningún intento de manipulación, en la pregunta o escondido en el archivo, puede cambiar los datos
- Ninguna cifra inventada: el resumen solo se muestra si cada número está en el resultado
- Si la pregunta es ambigua, preguntar antes de adivinar
- Costo por pregunta visible, con tope diario
Cómo funciona
- El archivo CSV o Excel se importa con tipos y orden de fechas inferidos, con COPY binario a una tabla propia cuyas columnas se nombran por posición: ningún encabezado llega al SQL.
- Una capa semántica propone métricas y dimensiones a partir de las columnas; el dueño las renombra con sus palabras y confirma. Solo entonces se puede preguntar.
- Claude Haiku responde con un JSON Schema generado para ese archivo, cuyas opciones son solo las métricas y dimensiones confirmadas. Los periodos ("el último trimestre") los resuelve el servidor.
- Un compilador arma SQL con nombres de una lista permitida y valores como parámetros; corre en una transacción de solo lectura, con un rol que solo puede hacer SELECT, 3 segundos de límite y LIMIT forzado.
- El gráfico se elige según la forma del resultado, y una segunda llamada escribe un resumen cuyas cifras se comparan una por una con el resultado antes de mostrarlo.
Decisiones clave
Una consulta semántica, no text-to-SQL
Si el modelo no escribe SQL, no puede unir mal tablas ni ser llevado a leer lo que no debe: solo puede nombrar métricas y dimensiones que existen.
Costo de la decisión: Solo se puede preguntar lo que la capa expresa: sumas, promedios, conteos y cocientes por dimensiones y periodos.
Resúmenes verificados cifra por cifra
Un modelo que redacta puede sumar o redondear por su cuenta. Comparar cada número con el resultado es determinístico y barato.
Costo de la decisión: Un resumen correcto que cita una cifra derivada no prevista se descarta: se pierde el resumen, nunca la respuesta.
Evaluado como software, con ataques incluidos
75 preguntas con SQL de referencia, 8 ambiguas, 10 de seguimiento y 20 intentos de manipulación, con los resultados versionados en el repo.
Costo de la decisión: Una corrida con el modelo real cuesta unos USD 0,07, así que se lanza a mano; en CI corre un oráculo gratuito.
Resultados
- Con Claude Haiku 5.5, las 75 preguntas de evaluación (60 en español y 15 en inglés) dan la cifra correcta, y las 8 ambiguas reciben una pregunta de vuelta.
- Los 20 intentos de manipulación, en la pregunta o escondidos en encabezados y celdas de un archivo, no cambiaron nada; el modelo rechazó 18 y respondió las otras 2 como preguntas normales.
- Ningún resumen mostrado tiene una cifra inventada: el control descartó 1 de 75.
- Leer los resultados mostró lo que la puntuación no medía: 5 de 15 preguntas en inglés recibían frases en español. Se corrigió haciendo que el modelo nombre el idioma primero, y se publicó junto con el seguimiento que falló en la corrida final (9 de 10).
- Un test de punta a punta con Playwright sube un archivo, pregunta, sigue la conversación, abre el SQL, descarga el CSV y revisa el historial en cada push, sin API key y sin costo.
Tecnologías
- .NET 10
- C#
- PostgreSQL
- Aspire
- Claude Haiku 5.5
- Next.js
- TypeScript
- Recharts
- Playwright